

Di-crawl – saat ini tidak diindeks artinya Googlebot sudah mengunjungi dan membaca halamanmu, tapi Google memutuskan belum memasukkannya ke indeks. Ini bukan error teknis, melainkan keputusan Google. Biasanya halaman dinilai belum cukup berguna, terlalu mirip dengan halaman lain, atau sinyal pentingnya lemah. Cara mengatasinya bukan menekan tombol “Minta Pengindeksan” berulang kali, tapi memperbaiki alasan Google melewati halaman itu.
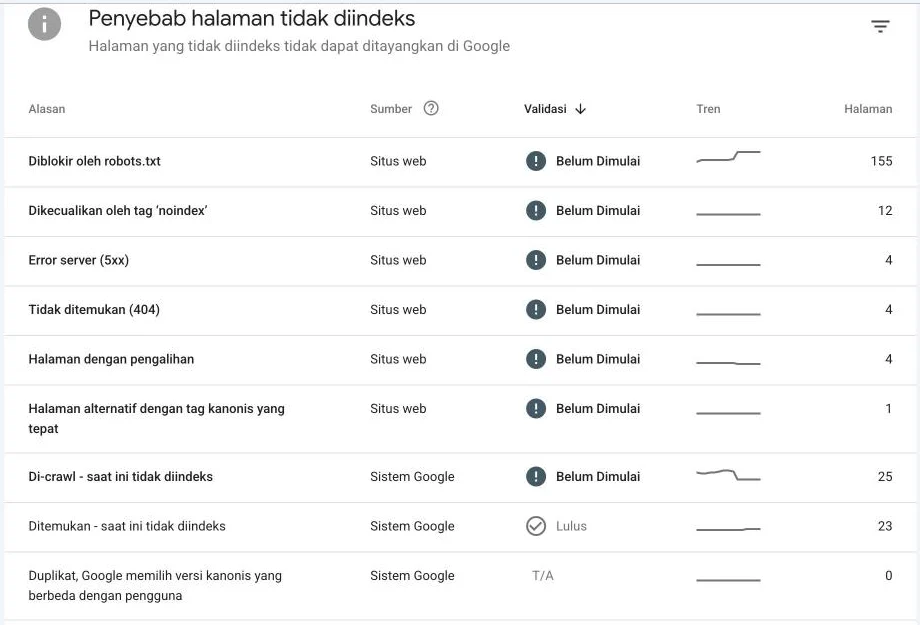
Saya SEO specialist di agency, dan learningwithdzul.com adalah website yang saya kelola sendiri. Di laporan Search Console terakhir (diperbarui 23 Oktober 2026), ada 25 URL di website ini yang berstatus di-crawl – saat ini tidak diindeks. Di artikel ini saya bedah ke-25 URL itu: apa polanya, mana yang perlu diperbaiki, dan mana yang memang tidak perlu ada di Google.
Apa arti “Di-crawl – saat ini tidak diindeks”?
Di laporan Pengindeksan halaman Google Search Console, setiap URL yang tidak diindeks diberi alasan. “Di-crawl – saat ini tidak diindeks” (di versi bahasa Inggris: Crawled – currently not indexed) artinya tiga hal:
- Google sudah menemukan URL-nya.
- Googlebot sudah meng-crawl, yaitu mengunjungi dan membaca, halaman tersebut.
- Google memilih tidak mengindeks halaman itu, setidaknya untuk sekarang.
Perhatikan kolom Sumber. Untuk alasan ini, sumbernya tertulis Sistem Google, bukan Situs web. Itu petunjuk penting: tidak ada yang rusak secara teknis seperti error 404, tag noindex, atau blokir robots.txt. Google bisa membaca halamanmu, lalu menilai halaman itu belum layak masuk indeks.
Menurut dokumentasi laporan Pengindeksan halaman dari Google, halaman dengan status ini mungkin diindeks di masa depan atau mungkin tidak, dan kamu tidak perlu mengirim ulang URL tersebut untuk di-crawl.

Bedanya dengan “Ditemukan – saat ini tidak diindeks”
Dua status ini sering tertukar, padahal artinya berbeda jauh.
| Status | Sudah di-crawl? | Artinya | Fokus perbaikan |
|---|---|---|---|
| Di-crawl – saat ini tidak diindeks | Sudah | Google membaca halaman, lalu memutuskan tidak mengindeksnya | Kualitas, keunikan, dan sinyal internal halaman |
| Ditemukan – saat ini tidak diindeks | Belum | Google tahu URL-nya, tapi belum meng-crawl | Prioritas crawl: internal link, sitemap, jumlah URL tidak penting |
Kalau URL-mu ada di status kedua, baca pembahasan lengkapnya di artikel ditemukan – saat ini tidak diindeks.
Studi kasus: 25 URL di learningwithdzul.com

Saya mengekspor daftar URL-nya, lalu mengelompokkannya berdasarkan jenis halaman:
| Kelompok | Jumlah | Contoh | Kenapa wajar dilewati Google |
|---|---|---|---|
| Artikel Self Development | 8 | /self-development/membaca/ | Artikel lama, pendek, dan di luar fokus website sekarang |
| Artikel Financial Market | 5 | /financial-market/apa-itu-overtrading/ | Topiknya berdekatan satu sama lain, sebagian masih tipis |
| Arsip dan tulisan pribadi | 3 | /pribadi/arti-dari-me-time/ | Tulisan personal, bukan jawaban atas pencarian |
| Halaman paginasi blog | 3 | /blog/page/19/ | Halaman daftar tanpa isi unik |
| Artikel SEO & Digital Marketing | 2 | /digital-marketing/content-writer-vs-script-writer/ | Pendek dan tumpang tindih dengan artikel writer lain |
| Lain-lain | 3 | /feed/, /bg-img-02/, satu puisi | Feed RSS, halaman lampiran gambar, dan karya sastra |
| Versi terjemahan (/en/) | 1 | /en/financial-market/kapan-harus-berhenti-trading/ | Versi bahasa Inggris dari artikel yang sudah ada |
Polanya cukup jelas. Sebagian besar URL adalah halaman yang memang tidak punya alasan kuat untuk muncul di Google. Halaman paginasi, feed, lampiran gambar, dan tulisan personal tidak menjawab pencarian siapa pun. Yang perlu diperhatikan justru 7 artikel: 5 di Financial Market dan 2 di SEO, karena itu konten yang saya harapkan mendatangkan pembaca.
Dua catatan lain dari daftar ini. Pertama, halaman lampiran gambar seperti /bg-img-02/ seharusnya tidak berdiri sendiri sebagai halaman. Di Yoast, pastikan opsi untuk mengalihkan halaman lampiran ke file gambarnya aktif. Kedua, versi /en/ dari artikel ikut di-crawl, padahal artikel di website ini memang hanya ditujukan untuk pembaca berbahasa Indonesia. Itu pekerjaan rumah tersendiri di pengaturan plugin terjemahan.
Mau belajar SEO langsung dari praktiknya?
Riset keyword, on-page, technical, sampai membaca data GSC, dengan cara kerja agency.
Kenapa Google tidak mengindeks halaman yang sudah di-crawl?
Google tidak mengindeks semua halaman yang ia temukan. Indeks punya standar kualitas, dan Google memilih halaman yang dianggap paling berguna. Penyebab yang paling umum:
1. Konten tipis atau tidak menambah apa-apa
Halaman yang isinya sudah ada di ratusan halaman lain, tanpa pengalaman, data, atau sudut pandang baru, mudah dilewati. Dua artikel SEO di daftar saya sama-sama pendek dan membahas hal yang juga dibahas artikel lain di website ini.
2. Terlalu mirip dengan halaman lain di website yang sama
Kalau dua halaman menjawab pertanyaan yang sama, Google cenderung memilih salah satu. content-writer-vs-script-writer adalah contohnya: topiknya bersinggungan dengan beberapa artikel writer lain di website ini. Situasi seperti ini dikenal sebagai keyword cannibalization, dan penanganannya biasanya lewat penggabungan atau diferensiasi konten.
3. Sinyal internal lemah
Halaman yang hampir tidak mendapat internal link dianggap kurang penting oleh website-nya sendiri, dan Google membaca sinyal itu. Cara membangunnya saya bahas di artikel internal link adalah.
4. Halaman yang memang tidak dimaksudkan untuk pencarian
Paginasi, feed, halaman lampiran, tag, dan arsip tipis. Untuk halaman seperti ini, status di-crawl tidak diindeks justru bukan masalah.
5. Kualitas website secara keseluruhan
Google tidak hanya menilai kualitas per halaman. Website dengan banyak halaman lemah bisa membuat Google lebih selektif terhadap halaman lain di website yang sama. Ini salah satu alasan saya mengeluarkan 158 artikel lama di kategori Self Development dari Google pada 4 November 2026.
Cara mendiagnosis per URL
- Buka Pengindeksan > Halaman di Search Console, lalu klik baris “Di-crawl – saat ini tidak diindeks”.
- Klik Ekspor di kanan atas untuk mengunduh daftar URL, lalu kelompokkan seperti tabel di atas.
- Untuk setiap URL yang penting, jalankan Inspeksi URL. Cek tanggal crawl terakhir, halaman perujuk, dan apakah kanonis yang dipilih Google sama dengan yang kamu tentukan.
- Buka halamannya dan tanya dengan jujur: kalau halaman ini hilang dari Google, apakah ada pembaca yang kehilangan sesuatu?
- Cek di laporan Performa apakah halaman lain di website-mu sudah mendapat impresi untuk kueri yang sama.
Kalau kamu belum terbiasa dengan laporan-laporan ini, panduannya ada di artikel cara menggunakan Google Search Console.
Cara mengatasi: satu keputusan untuk setiap URL
Setiap URL di daftar ini berakhir di salah satu dari empat keputusan:
| Keputusan | Kapan dipakai | Yang dilakukan |
|---|---|---|
| Perbaiki | Halamannya penting dan topiknya unik | Tambah pengalaman, data, dan contoh nyata; perkuat judul; tambah internal link dari halaman relevan |
| Gabungkan | Ada halaman lain yang membahas hal yang sama | Pindahkan bagian unik ke halaman yang lebih kuat, lalu pasang redirect 301 |
| Noindex | Berguna untuk pengunjung, tapi bukan untuk pencarian | Pasang tag noindex dan keluarkan dari sitemap |
| Biarkan | Paginasi, feed, lampiran | Tidak perlu tindakan, status ini wajar |
Ini yang saya putuskan untuk ke-25 URL tadi:
- 8 artikel Self Development: sudah diberi noindex dan dikeluarkan dari sitemap pada 4 November 2026, bersama artikel lain di kategori yang sama.
- 2 artikel SEO: masuk antrean perbaikan. Keduanya akan diperkuat dengan pengalaman langsung atau digabung jika ternyata tumpang tindih dengan artikel yang lebih kuat.
- 5 artikel Financial Market: dievaluasi di dalam klaster psikologi trading, mana yang diperkuat dan mana yang digabung.
- 3 tulisan pribadi dan 1 puisi: dipertahankan untuk pembaca, kandidat noindex.
- Paginasi, feed, dan versi /en/: dibiarkan, sambil merapikan pengaturan terjemahan dan halaman lampiran.
Kapan klik “Validasi perbaikan” dan “Minta pengindeksan”?
- Minta pengindeksan per URL hanya setelah halamannya benar-benar berubah. Menekan tombol tanpa mengubah apa pun tidak mengubah penilaian Google.
- Validasi perbaikan di laporan baru masuk akal setelah sebagian besar URL di kelompok itu diperbaiki. Menurut Google, validasi biasanya memakan waktu hingga sekitar dua minggu, bisa lebih lama.
- Jangan berharap semua URL masuk indeks. Untuk halaman yang memang tidak dimaksudkan untuk pencarian, status ini akan tetap ada, dan itu tidak apa-apa.
Kesalahan yang sering terjadi
- Menganggap status ini error teknis, lalu sibuk mengutak-atik server atau plugin.
- Menekan “Minta pengindeksan” berkali-kali untuk halaman yang sama tanpa mengubah isinya.
- Memakai layanan “instant indexing” pihak ketiga. Indexing API Google secara resmi hanya untuk halaman lowongan kerja dan siaran langsung.
- Mengejar semua URL agar terindeks, termasuk paginasi dan feed.
- Memblokir halaman dengan robots.txt agar hilang dari laporan. Cara ini justru membuat Google tidak bisa membaca tag noindex.
FAQ seputar di-crawl saat ini tidak diindeks
Apakah “di-crawl saat ini tidak diindeks” itu penalti?
Bukan. Ini bukan tindakan manual. Tindakan manual punya laporan sendiri di Search Console, di menu Keamanan & Tindakan Manual. Status ini adalah penilaian algoritmis bahwa halaman belum layak masuk indeks.
Kenapa web tidak terindeks Google?
Penyebab paling umum: Google belum menemukan halamannya, halaman diblokir noindex atau robots.txt, atau halaman dinilai belum cukup berguna. Jalankan Inspeksi URL untuk mengetahui alasan pastinya.
Bagaimana cara agar artikel cepat terindeks di Google?
Pastikan artikel bisa di-crawl, masuk sitemap, mendapat internal link dari halaman yang sudah terindeks, dan punya isi yang tidak sekadar mengulang halaman lain. Setelah itu, minta pengindeksan sekali lewat Inspeksi URL.
Berapa lama proses index Google?
Tidak ada angka pasti dari Google. Crawl ulang bisa terjadi beberapa hari setelah kamu meminta pengindeksan, tapi keputusan mengindeks bergantung pada penilaian Google terhadap halaman itu. Ekspektasi waktu yang lebih luas saya bahas di artikel berapa lama SEO bisa memberikan hasil.
Kesimpulan
Status di-crawl – saat ini tidak diindeks adalah sinyal kualitas, bukan masalah teknis. Ekspor daftar URL-nya, kelompokkan, lalu beri setiap URL satu keputusan: perbaiki, gabungkan, noindex, atau biarkan. Di website ini, dari 25 URL, hanya 7 artikel yang benar-benar perlu dikerjakan. Sisanya memang tidak perlu ada di Google.
Kalau kamu ingin dibantu membaca laporan Search Console website-mu sendiri, lihat Mentoring SEO.

