


Robots.txt adalah file teks di root website yang memberi tahu crawler mesin pencari bagian mana yang boleh dan tidak boleh di-crawl. Fungsinya mengatur lalu lintas crawler, bukan menyembunyikan halaman dari Google. Halaman yang diblokir robots.txt masih bisa muncul di hasil pencarian tanpa deskripsi kalau ada link yang mengarah ke sana. Untuk mengeluarkan halaman dari Google, alat yang tepat adalah tag noindex.
Saya pernah memakai robots.txt dengan cara yang salah di website ini. Sebelum November 2026, seluruh kategori Self Development saya blokir dengan Disallow: /self-development/, dengan niat mengeluarkannya dari Google. Hasilnya di Search Console: 155 URL berstatus “Diblokir oleh robots.txt”, dan Google tidak pernah bisa membaca bahwa saya sebenarnya tidak ingin halaman itu diindeks. Artikel ini menjelaskan cara kerja robots.txt yang benar, termasuk pelajaran dari kesalahan itu.
Apa itu robots.txt?
Robots.txt adalah bagian dari Robots Exclusion Protocol. File ini selalu berada di root domain, misalnya https://learningwithdzul.com/robots.txt. Sebelum meng-crawl sebuah website, Googlebot mengecek file ini lebih dulu.
Yang bisa dilakukan robots.txt:
- Mencegah crawler membuang waktu di area tidak penting, seperti halaman admin, hasil pencarian internal, atau URL filter dengan parameter.
- Mengurangi beban server dari crawler.
- Memberi tahu lokasi sitemap.
- Mengatur akses crawler tertentu, termasuk crawler AI.
Yang tidak bisa dilakukan robots.txt:
- Menjamin halaman tidak muncul di Google.
- Melindungi halaman rahasia. File ini publik dan bisa dibaca siapa saja.
- Memaksa crawler nakal untuk patuh. Robots.txt hanya diikuti crawler yang taat aturan.
Lokasi dan format file robots.txt
- Satu file untuk setiap host, diletakkan di root. File di
https://domain.com/blog/robots.txttidak akan dibaca. - Nama file harus huruf kecil:
robots.txt. - Subdomain punya robots.txt sendiri.
blog.domain.comtidak mengikuti aturan didomain.com. - Google memproses robots.txt hingga 500 KiB. Aturan setelah batas itu diabaikan.
Format dasarnya berupa grup aturan yang dimulai dengan User-agent:
User-agent: *
Disallow: /wp-admin/
Allow: /wp-admin/admin-ajax.php

Sitemap: https://domain.com/sitemap_index.xml
Arti setiap aturan
| Aturan | Fungsi | Contoh |
|---|---|---|
| User-agent | Crawler yang dituju. Tanda * berarti semua crawler | User-agent: Googlebot |
| Disallow | Path yang tidak boleh di-crawl | Disallow: /cari/ |
| Allow | Pengecualian di dalam path yang di-Disallow | Allow: /wp-admin/admin-ajax.php |
| Sitemap | Lokasi sitemap, wajib URL lengkap | Sitemap: https://domain.com/sitemap_index.xml |
Google juga mendukung dua karakter khusus: * untuk “karakter apa pun” dan $ untuk “akhir URL”. Contohnya, Disallow: /*?s= memblokir halaman hasil pencarian internal WordPress, dan Disallow: /*.pdf$ memblokir semua file PDF.
Dua hal yang sering disalahpahami: Google tidak mendukung aturan Crawl-delay, dan sejak 2019 Google tidak lagi mendukung aturan Noindex: di dalam robots.txt.
Mau belajar SEO langsung dari praktiknya?
Riset keyword, on-page, technical, sampai membaca data GSC, dengan cara kerja agency.
Contoh robots.txt untuk WordPress
Ini robots.txt website ini setelah saya perbaiki pada 4 November 2026:
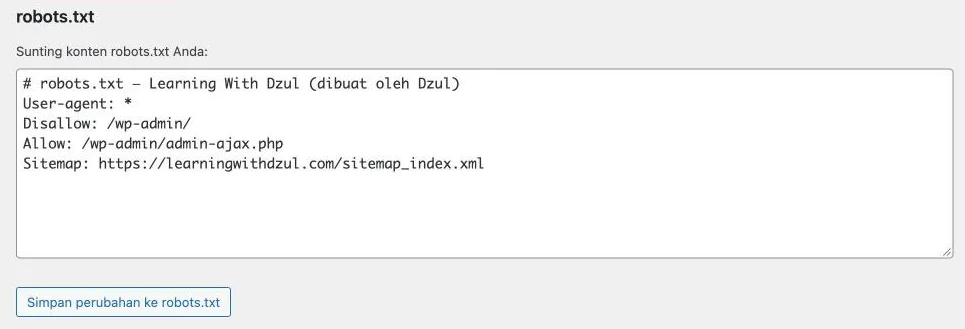
Penjelasannya:
Disallow: /wp-admin/mencegah crawler masuk ke area admin.Allow: /wp-admin/admin-ajax.phptetap mengizinkan file yang dipakai sebagian tema dan plugin untuk memuat konten di halaman depan.Sitemap:memberi tahu lokasi sitemap index yang dibuat Yoast.
Sebelumnya, file yang sama berisi satu baris tambahan:
User-agent: *
Disallow: /wp-admin/
Allow: /wp-admin/admin-ajax.php
Disallow: /self-development/

Sitemap: https://learningwithdzul.com/sitemap_index.xml
Baris keempat itulah yang menyebabkan masalah yang saya ceritakan di awal.
Cara mengedit robots.txt di WordPress
Secara bawaan, WordPress membuat robots.txt virtual. Kalau ada file robots.txt fisik di root folder, file fisik itulah yang dipakai. Ada tiga cara mengeditnya:
- Lewat Yoast SEO: buka Yoast SEO > Alat > File editor, ubah isi kotak robots.txt, lalu klik Simpan perubahan ke robots.txt. Menu ini hanya muncul jika WordPress diizinkan mengedit file.
- Lewat Rank Math: buka pengaturan umum Rank Math, lalu menu Edit robots.txt.
- Lewat file manager hosting: buat atau edit file
robots.txtdi folder root (biasanyapublic_html).
Setelah mengedit, buka domain.com/robots.txt di browser untuk memastikan perubahannya terbaca. Di Search Console, laporan robots.txt di menu Setelan menunjukkan versi terakhir yang diambil Google dan apakah ada error.
Mengatur crawler AI di robots.txt
Robots.txt juga dipakai untuk mengatur crawler AI. Contohnya:
User-agent: GPTBot
Disallow: /

User-agent: Google-Extended
Disallow: /GPTBotadalah crawler OpenAI untuk pelatihan model. OpenAI memakai crawler terpisah, OAI-SearchBot, untuk fitur pencarian di ChatGPT.Google-Extendedadalah token yang mengatur apakah konten yang di-crawl Google boleh dipakai untuk model Gemini. Menurut Google, token ini tidak memengaruhi penampilan website di Google Search.- Jangan pernah memblokir
Googlebotkalau kamu ingin muncul di Google, termasuk di AI Overviews.
Website ini tidak memblokir crawler AI apa pun, karena tujuan saya justru agar konten bisa ditemukan dan dikutip.
Kesalahan robots.txt yang paling berbahaya
1. Memakai Disallow untuk mengeluarkan halaman dari Google
Ini kesalahan yang saya buat. Karena halaman diblokir, Googlebot tidak bisa membacanya, termasuk tidak bisa membaca tag noindex. URL tetap tercatat di Search Console sebagai “Diblokir oleh robots.txt”, dan bisa saja tampil di hasil pencarian tanpa deskripsi.

2. Disallow: / di website yang sudah live
Satu baris Disallow: / memblokir seluruh website. Kesalahan ini sering terjadi saat robots.txt dari website staging ikut terbawa ke website live.
3. Memblokir file CSS dan JavaScript
Google merender halaman seperti browser. Kalau CSS atau JavaScript diblokir, Google bisa salah memahami tampilan dan isi halamanmu.
4. Memblokir halaman yang memakai noindex atau canonical
Tag noindex dan canonical hanya bisa dibaca kalau halamannya boleh di-crawl.
5. Salah menulis path
Aturan bersifat awalan dan peka huruf besar-kecil. Disallow: /blog juga memblokir /blog-tips/ dan /blogger/. Kalau maksudnya hanya folder, tulis Disallow: /blog/.
Robots.txt vs noindex: kapan pakai yang mana?
| Tujuan | Pakai |
|---|---|
| Menghemat crawl di area yang tidak penting | robots.txt |
| Mengeluarkan halaman dari hasil pencarian | noindex |
| Menghapus halaman yang sudah terindeks | noindex, jangan diblokir dulu |
| Mengeluarkan file non-HTML seperti PDF | Header X-Robots-Tag: noindex |
Di website ini, saya memindahkan 158 artikel Self Development dari blokir robots.txt ke noindex pada 4 November 2026. Kisah lengkap perpindahan itu, termasuk hasil uji di Search Console, adalah topik artikel berikutnya di seri indexing ini.
Kalau URL-mu tertahan di status lain, baca juga di-crawl – saat ini tidak diindeks dan ditemukan – saat ini tidak diindeks.
FAQ seputar robots.txt
Robots.txt untuk apa?
Untuk mengatur bagian website mana yang boleh di-crawl oleh crawler mesin pencari, mengurangi beban server, dan memberi tahu lokasi sitemap.
Di mana lokasi standar file robots.txt pada website?
Di root domain, yaitu https://namadomain.com/robots.txt. Crawler tidak mencari file ini di folder lain.
Apa yang dimaksud dengan crawler?
Crawler adalah program otomatis yang mengunjungi halaman web dan mengikuti link untuk menemukan halaman baru. Crawler milik Google bernama Googlebot.
Apakah website wajib punya robots.txt?
Tidak. Jika file ini tidak ada dan server membalas 404, Google menganggap semua halaman boleh di-crawl. Yang berbahaya justru jika robots.txt membalas error server (5xx), karena Google bisa menahan crawl sampai file itu bisa diakses.
Kesimpulan
Robots.txt adalah alat untuk mengatur crawl, bukan untuk mengatur indeks. Pakai untuk menjauhkan crawler dari area yang tidak penting, cantumkan lokasi sitemap, dan jangan pernah memakainya untuk menyembunyikan halaman dari Google. Untuk itu, gunakan noindex dan biarkan Google meng-crawl halamannya.
Penjelasan teknis SEO lainnya bisa kamu mulai dari artikel technical SEO untuk pemula.

