


Noindex adalah perintah di halaman, lewat meta tag robots atau header HTTP X-Robots-Tag, yang memberi tahu Google agar tidak memasukkan halaman itu ke indeks. Halaman tetap bisa dikunjungi, tapi tidak muncul di hasil pencarian. Syarat utamanya: Google harus bisa meng-crawl halaman tersebut untuk membaca perintahnya. Karena itu, noindex tidak boleh dikombinasikan dengan blokir robots.txt.
Pada 4 November 2026, saya memindahkan 158 artikel di kategori Self Development website ini dari blokir robots.txt ke noindex. Dua hari kemudian, saya menguji ulang salah satu URL-nya di Search Console. Hasilnya menunjukkan persis kenapa perpindahan ini perlu dilakukan.

Apa itu noindex?
Ada dua cara memberikan perintah noindex. Yang paling umum adalah meta tag di bagian <head> halaman:
<meta name="robots" content="noindex, follow">Untuk file non-HTML seperti PDF, perintah yang sama dikirim lewat header HTTP:
X-Robots-Tag: noindexKata follow berarti link di halaman itu tetap boleh diikuti. Jadi halaman keluar dari indeks, tapi Googlebot masih bisa menemukan halaman lain lewat link di dalamnya.
Crawling vs indexing: dua tahap yang berbeda
Untuk memahami noindex, kamu perlu membedakan dua tahap ini:
- Crawling: Googlebot mengunjungi halaman dan membaca isinya.
- Indexing: Google menyimpan halaman itu di indeks agar bisa ditampilkan di hasil pencarian.
Robots.txt bekerja di tahap crawling, sedangkan noindex bekerja di tahap indexing. Masalahnya, noindex tertulis di dalam halaman. Kalau halaman tidak boleh di-crawl, Google tidak akan pernah membaca perintah noindex itu.
Noindex vs robots.txt
| Blokir robots.txt (Disallow) | Tag noindex | |
|---|---|---|
| Bekerja di tahap | Crawling | Indexing |
| Google bisa membaca isi halaman | Tidak | Ya |
| Halaman bisa muncul di Google | Bisa, tanpa deskripsi, jika ada link ke halaman itu | Tidak, setelah Google membaca tagnya |
| Cocok untuk | Area yang tidak perlu di-crawl | Halaman yang tidak perlu muncul di pencarian |
| Status di Search Console | Diblokir oleh robots.txt | Dikecualikan oleh tag ‘noindex’ |
Kesalahan klasiknya adalah memasang keduanya sekaligus. Robots.txt mencegah Google membaca noindex, jadi noindex-nya tidak pernah berlaku. Penjelasan lengkap soal robots.txt ada di artikel robots.txt adalah.
Mau belajar SEO langsung dari praktiknya?
Riset keyword, on-page, technical, sampai membaca data GSC, dengan cara kerja agency.
Studi kasus: memindahkan 158 artikel dari robots.txt ke noindex
Kategori Self Development di website ini berisi 158 artikel lama yang tidak lagi sesuai dengan fokus website, yaitu SEO dan trading. Saya ingin artikel itu tetap bisa dibaca, tapi tidak tampil di Google.
Sebelum: seluruh kategori diblokir dengan Disallow: /self-development/ di robots.txt. Akibatnya, 155 URL tercatat “Diblokir oleh robots.txt” di Search Console. Sebagian artikel lain dari kategori yang sama justru muncul di status “Ditemukan” dan “Di-crawl – saat ini tidak diindeks”. Hasilnya berantakan dan tidak sesuai niat awal.

Langkah yang saya lakukan pada 4 November 2026:
- Memasang noindex untuk semua post di kategori itu dan halaman arsipnya. Yoast punya pengaturan noindex per tipe konten dan per arsip taksonomi, tapi tidak untuk semua post di satu kategori. Karena itu saya memakai filter
wpseo_robotslewat plugin WPCode. - Mengeluarkan post-post itu dari sitemap. Noindex yang dipasang lewat filter tidak otomatis mengeluarkan URL dari sitemap Yoast, jadi saya menambahkan filter
wpseo_exclude_from_sitemap_by_post_ids. - Menghapus baris Disallow dari robots.txt, supaya Google bisa meng-crawl halaman dan membaca noindex-nya.
- Membersihkan cache dan mengecek meta robots di halaman depan dalam kondisi tidak login.
- Menguji satu URL dengan Uji URL aktif di Search Console.
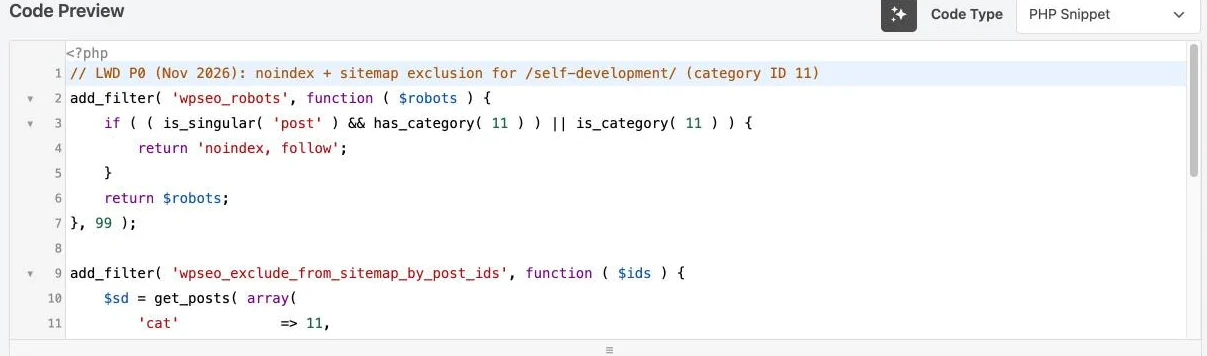
Inti kodenya hanya beberapa baris:
add_filter( 'wpseo_robots', function ( $robots ) {
    if ( ( is_singular( 'post' ) && has_category( 11 ) ) || is_category( 11 ) ) {
        return 'noindex, follow';
    }
    return $robots;
}, 99 );
Ganti angka 11 dengan ID kategorimu. Kalau kamu tidak nyaman memakai kode, alternatifnya adalah mengatur noindex satu per satu di kotak Yoast setiap post.
Hasil per 6 November 2026: uji langsung menunjukkan Google kini membaca halaman dan menemukan tag noindex. Laporan Pengindeksan halaman sendiri belum berubah, karena terakhir diperbarui 23 Oktober 2026. Perpindahan dari “Diblokir oleh robots.txt” ke “Dikecualikan oleh tag noindex” baru akan terlihat bertahap, mengikuti jadwal Google meng-crawl ulang setiap URL.
Cara memasang noindex di WordPress
- Satu post atau halaman: buka editor, cari kotak Yoast SEO, tab Lanjutan, lalu atur agar mesin pencari tidak menampilkan konten ini di hasil pencarian.
- Satu tipe konten atau arsip: di Yoast SEO > Pengaturan, buka bagian tipe konten atau taksonomi, lalu matikan opsi untuk menampilkannya di hasil pencarian.
- Semua post di satu kategori: pakai filter
wpseo_robotsseperti contoh di atas. - File PDF atau gambar: gunakan header
X-Robots-Taglewat konfigurasi server.
Kapan sebaiknya memakai noindex?
Pakai noindex untuk halaman yang berguna bagi pengunjung, tapi tidak perlu tampil di pencarian:
- Halaman terima kasih, login, dan hasil pencarian internal.
- Arsip tag dan arsip penulis yang tipis. Di blog dengan satu penulis, arsip penulis biasanya hanya menduplikasi daftar artikel.
- Konten lama di luar topik yang tetap ingin kamu pertahankan untuk pembaca setia.
- Landing page iklan yang isinya mirip dengan halaman lain.
Jangan pakai noindex untuk:
- Halaman yang ingin kamu ranking-kan. Kedengarannya jelas, tapi noindex yang tidak sengaja terpasang di template adalah kasus yang sering terjadi.
- Konten duplikat yang punya versi utama. Untuk itu, canonical biasanya lebih tepat.
- Halaman yang akan digabung ke halaman lain. Untuk itu, pakai redirect 301.
Satu catatan: kalau tujuanmu hanya agar konten tidak dikutip di ringkasan AI Google, noindex terlalu keras karena halaman akan hilang dari Google sepenuhnya. Pilihan yang lebih presisi saya bahas di bagian cara keluar dari AI Overview.
Cara mengecek noindex sudah aktif
- Buka halaman dalam kondisi tidak login, klik kanan, pilih Lihat sumber halaman, lalu cari
name="robots". - Di Search Console, jalankan Inspeksi URL, lalu klik Uji URL aktif. Hasilnya harus menyebut “Dikecualikan oleh tag ‘noindex'”.
- Setelah beberapa minggu, cek laporan Pengindeksan > Halaman. Di laporan saya, sudah ada 12 URL di status “Dikecualikan oleh tag ‘noindex'” sebelum perubahan ini, dari halaman yang memang sejak awal di-noindex.
Untuk memahami status lain di laporan yang sama, baca di-crawl – saat ini tidak diindeks dan ditemukan – saat ini tidak diindeks.
FAQ seputar noindex
Apa itu no index?
Noindex adalah perintah agar halaman tidak dimasukkan ke indeks mesin pencari, sehingga tidak muncul di hasil pencarian, walaupun halamannya tetap bisa diakses.
Apa perbedaan crawling dan indexing?
Crawling adalah proses Googlebot mengunjungi dan membaca halaman. Indexing adalah proses menyimpan halaman itu agar bisa ditampilkan di hasil pencarian. Halaman bisa di-crawl tanpa diindeks, tapi tidak bisa diindeks dengan benar tanpa di-crawl.
Bagaimana cara agar website terindeks Google?
Kebalikan dari noindex: pastikan halaman tidak memakai tag noindex, tidak diblokir robots.txt, masuk sitemap, mendapat internal link, lalu minta pengindeksan lewat Search Console.
Berapa lama halaman noindex hilang dari Google?
Setelah Google meng-crawl ulang halaman dan membaca tagnya. Waktunya bervariasi. Untuk kebutuhan mendesak, alat Penghapusan di Search Console bisa menyembunyikan URL sementara selama sekitar enam bulan, sambil menunggu noindex terbaca.
Kesimpulan
Noindex mengatur indeks, robots.txt mengatur crawl. Kalau tujuanmu mengeluarkan halaman dari Google, pasang noindex dan biarkan Google meng-crawl halamannya. Jangan blokir halaman itu di robots.txt, karena Google tidak akan pernah membaca perintahmu. Di website ini, perpindahan 158 artikel membutuhkan empat langkah: noindex, keluarkan dari sitemap, cabut blokir robots.txt, lalu uji di Search Console.
Kalau kamu ingin dibantu merapikan indexing website-mu, lihat Mentoring SEO.

